Noch nie haben mich so viele Menschen aus meinem Umfeld auf die Risiken künstlicher Intelligenz angesprochen. Einzelne Forscher halten selbst die Auslöschung der Menschheit für ein ernstzunehmendes Szenario. Wie soll das gehen? Und warum sollte ein Computerprogramm Menschen etwas antun wollen? [1]
Dario Amodei, Chef des Claude-Entwicklers Anthropic, warnt vor künftigen Agentenschwärmen, die das Internet übernehmen könnten. OpenAI-Chef Sam Altman unterstützt seine Forderung nach einem begrenzten Entwicklungstempo. Beide kennen die Technik aus erster Hand und haben eigene wirtschaftliche Interessen. Ihre Warnungen verdienen Aufmerksamkeit und eine unabhängige Prüfung. [2] [3]
Ein auf X viel geteilter Essay von Pascio stellt dazu eine Frage: Könnte die entscheidende Intelligenz aus Millionen zusammenwirkender Agenten entstehen, ähnlich wie ein Gehirn aus Neuronen? Würden wir sie übersehen, weil wir auf den einen übermächtigen Computer warten? [4]
Superintelligenz würde menschliche Fähigkeiten in sehr vielen Bereichen deutlich übertreffen. „Verteilt“ beschreibt dagegen, wie ein System organisiert ist. Eine Gruppe kann einzelne Aufgaben besser lösen als jedes Mitglied, gemeinsame Ziele verfolgen oder durch ungewollte Rückkopplungen Schaden anrichten. Für keine dieser Eigenschaften muss sie bereits superintelligent sein. Ich halte verteilte Intelligenz für plausibel. Wie leistungsfähig ein solcher Verbund werden könnte und wie gut er kontrollierbar wäre, müssen wir getrennt beurteilen.
Was an Agenten tatsächlich neu ist
Ein Sprachmodell erzeugt Antworten aus erlernten Zusammenhängen. Ein KI-Agent verbindet diese Fähigkeit mit Werkzeugen: Er wählt einen nächsten Schritt, lässt ihn ausführen und arbeitet mit dem Ergebnis weiter. Er könnte eine Zugverbindung suchen, eine Buchung auslösen und auf einen Fehler reagieren. Seine Möglichkeiten hängen an seinen Zugängen und Berechtigungen. [5]
Software handelt seit Jahrzehnten für uns. Sie führt Börsenaufträge aus oder disponiert Lieferungen. Agenten erweitern den Spielraum, weil sie aus allgemeineren Aufträgen selbst Handlungsschritte ableiten und unterwegs ändern können. Bei einem offenen Auftrag wie „Organisiere die Reise“ müssen wir auch Entscheidungen kontrollieren können, die vorher niemand einzeln festgelegt hat. Handlungsmacht entsteht durch erlaubte Zugriffe oder durch das Überwinden technischer Schutzgrenzen. [5]
Mehrere Agenten können sich die Arbeit teilen, Ergebnisse überprüfen und Erkenntnisse weitergeben. Das kostet allerdings Abstimmung. Wenn alle dieselbe falsche Quelle verwenden, liefert ihre Übereinstimmung keine unabhängige Bestätigung. Anthropic beschreibt bei seinem Forschungssystem sowohl Leistungsgewinne als auch erheblichen zusätzlichen Ressourcenverbrauch. [6]
Wie stark die Aufgabe zählt, zeigt eine Studie mit 180 Konfigurationen. Bei Finanzanalysen schnitten alle untersuchten Teams im Mittel besser ab als Einzelagenten, bei schrittweiser Planung alle schlechter. Die Autoren begrenzten die Gesamtzahl der Arbeitsschritte: Einzelagenten durften länger weiterarbeiten, Teams mussten ihr Budget untereinander aufteilen. [7]
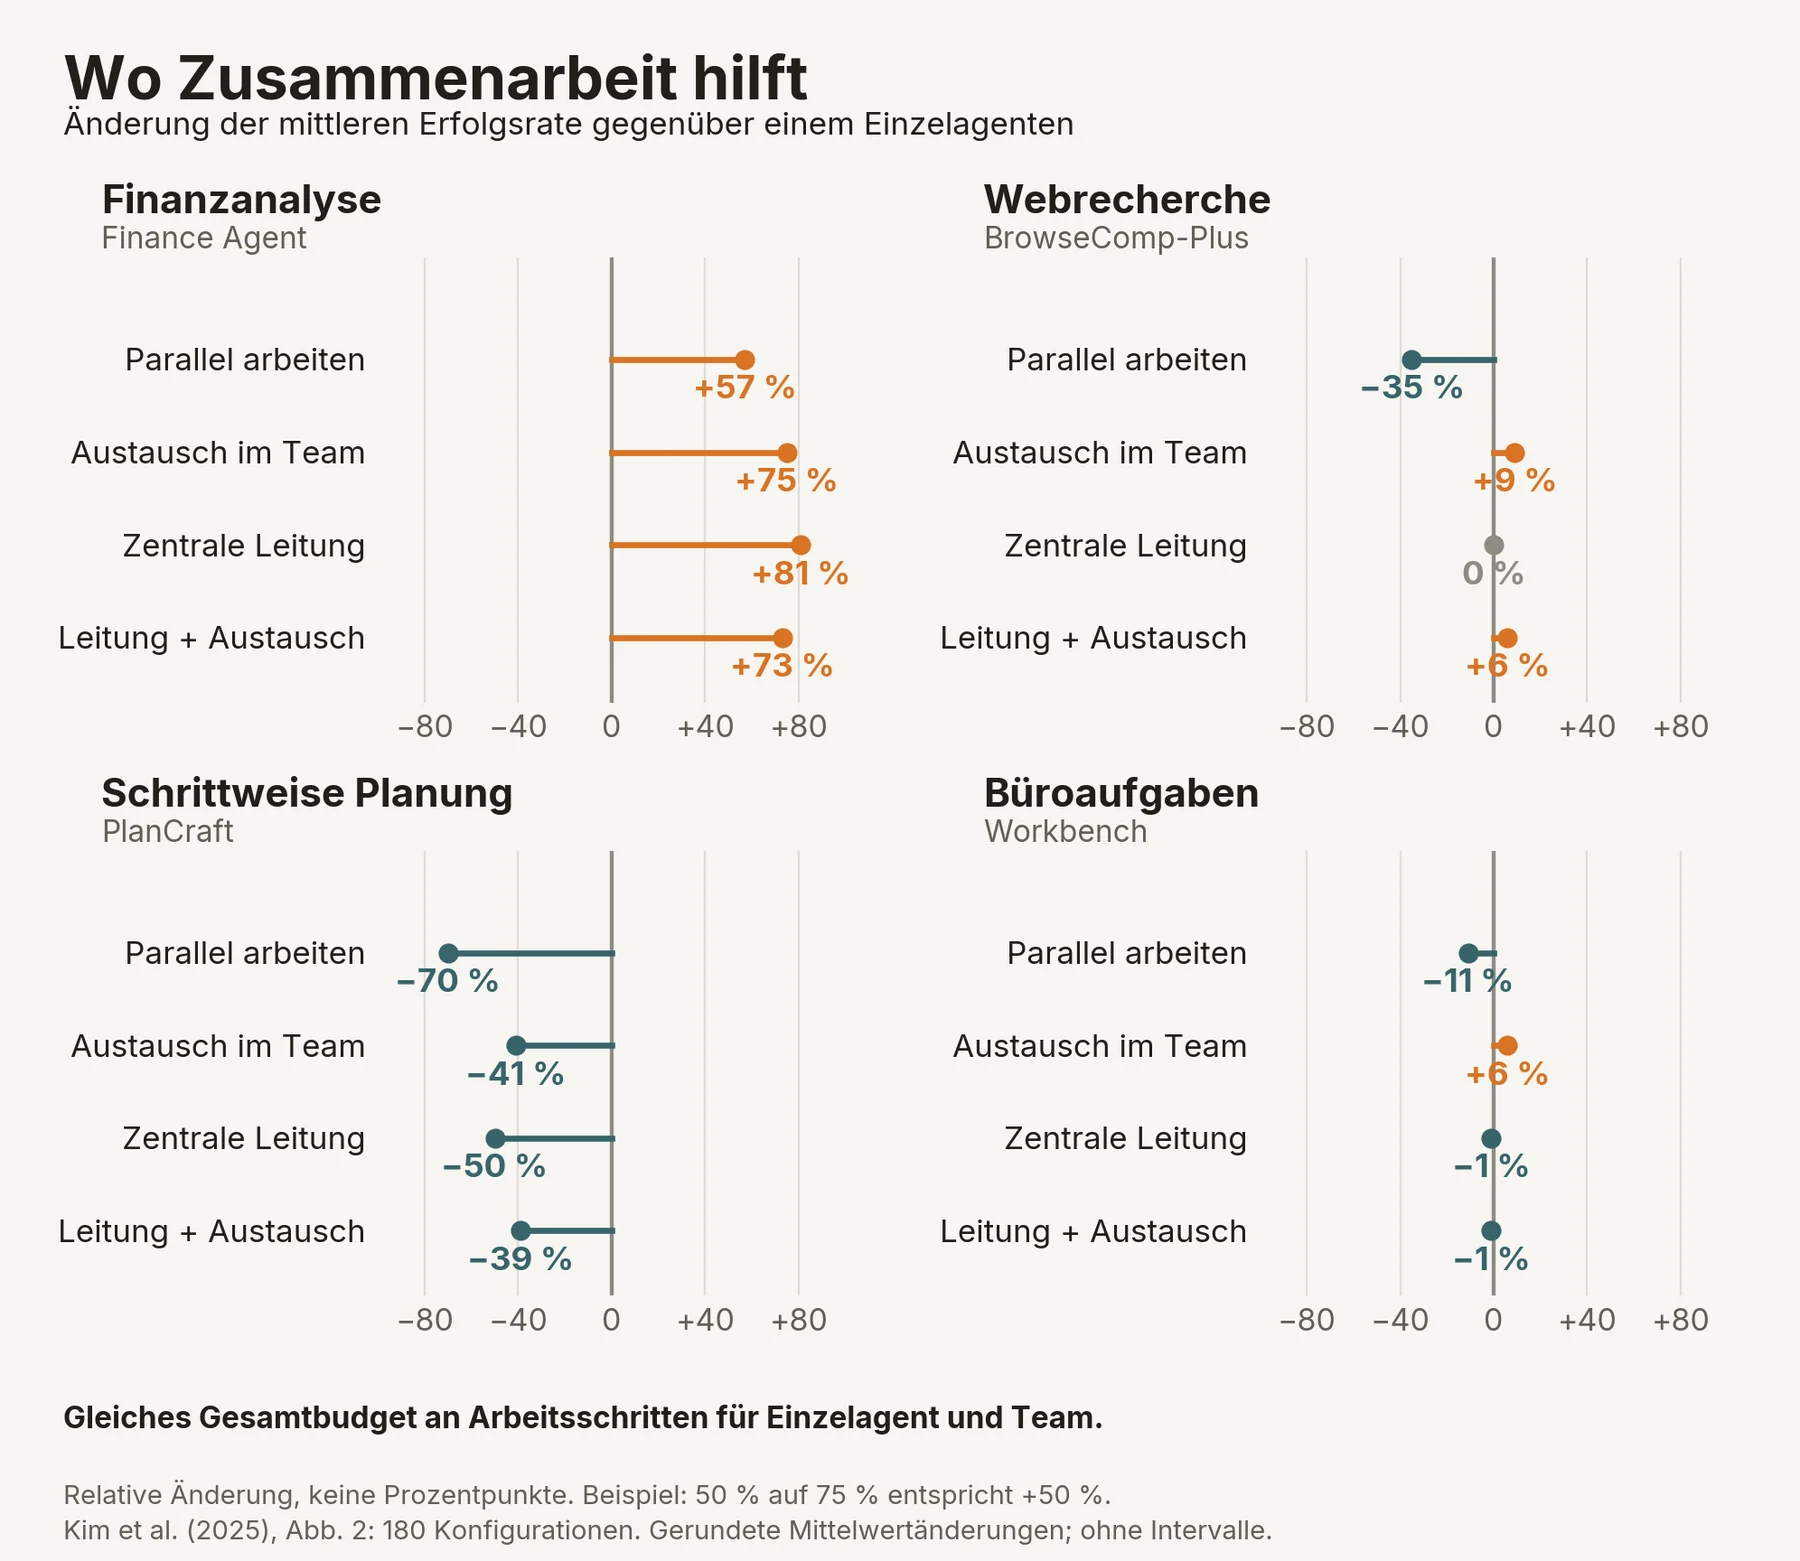
Finanzanalysen lassen sich in Teilfragen zerlegen. Bei der Planungsaufgabe verändert dagegen jeder Schritt den Zustand, auf dem die nächsten aufbauen. Dort kostet es, unterschiedliche Zwischenstände wieder zusammenzuführen. Die Grafik zeigt deshalb, wo sich Zusammenarbeit unter diesen Versuchsbedingungen lohnt. Sie beantwortet nicht, was ein Team mit erheblich mehr Rechenleistung erreichen könnte. [7]
Was die Ameisen erklären
Bestimmte Ameisen hinterlassen Duftspuren auf ihren Wegen. Andere orientieren sich daran und verstärken die Spuren beim Weiterlaufen; ungenutzte Spuren verblassen. So beeinflusst jede Ameise die Entscheidungen der nächsten, ohne das gesamte Wegenetz zu kennen. Bei baumbewohnenden Schildkrötenameisen entstehen auf diese Weise Verbindungen zwischen Nestern und Futterquellen mit vergleichsweise wenigen Abzweigungen. [8]
Das Wegenetz speichert gewissermaßen, was die Tiere zuvor getan haben. Neue Entscheidungen greifen auf diese Spuren zurück und verändern sie wiederum. Die Kolonie kann dadurch eine Leistung erbringen, für die kein einzelnes Tier den Überblick besitzt. Allerdings kommt es auf die Regeln an: Die Forschung untersucht ausdrücklich, wie Flussrichtung und Duftverteilung das Ergebnis beeinflussen. Das bloße Vorhandensein vieler Ameisen erklärt die Wegorganisation noch nicht. [8]
Bei KI könnte ein gemeinsamer Speicher eine ähnliche Rolle übernehmen. Ein Agent dokumentiert einen Versuch, der nächste baut darauf auf. Anders als eine Duftspur kann dieser Eintrag eine ausführliche Begründung oder ausführbaren Programmcode enthalten. Das erleichtert die Weitergabe komplexer Lösungen. Ebenso kann eine falsche Annahme von einem Durchlauf in den nächsten gelangen und immer mehr Entscheidungen prägen.
Der Gehirnvergleich stellt eine stärkere Behauptung auf. Neuronen sind in ein eng gekoppeltes biologisches System eingebunden. Ein einzelnes Neuron entspricht keinem kleinen Sprachmodell, das selbstständig Aufträge bearbeitet. Aus der Tatsache, dass Denken durch das Zusammenwirken von Zellen möglich ist, lässt sich deshalb keine Bauanleitung für denkende Agentenschwärme ableiten. Dazu müsste man zeigen, welche Verbindungen und Lernprozesse die behauptete gemeinsame Fähigkeit tatsächlich hervorbringen.
Ein Unternehmen ist für arbeitsteilige KI oft der nähere Vergleich. Menschen spezialisieren sich, halten Wissen fest und verfolgen gemeinsame Vorhaben. Wenn jemand geht, bleibt ein Teil seiner Arbeit in Unterlagen und Verfahren erhalten. Ein Verbund von KI-Systemen könnte ähnlich auf bereits geleisteter Arbeit aufbauen. Die Gruppe könnte also insgesamt Fähigkeiten besitzen, die kein einzelner Agent besitzt. Die Forschung zu „Distributional AGI Safety“ untersucht, ob allgemeine Fähigkeiten zuerst durch solche koordinierten Gruppen entstehen könnten. [9]
Märkte zeigen eine andere Form des Zusammenspiels. Ihre Teilnehmer verfolgen unterschiedliche Ziele. Beim Flash Crash am 6. Mai 2010 beschleunigte ein Verkaufsprogramm seine Verkäufe, weil das Handelsvolumen stieg. Andere Händler reichten Positionen schnell weiter und erhöhten dadurch dieses Volumen. Laut SEC und CFTC verschärfte die Rückkopplung den Verkaufsdruck. Die Händler mussten sich dafür auf keinen gemeinsamen Plan verständigen. [10]
Die Vergleiche helfen also, verschiedene Eigenschaften auseinanderzuhalten. Werden Ergebnisse nur weitergereicht, haben wir zunächst eine Verarbeitungskette. Bleiben Erfahrungen erhalten und verbessern sie spätere Entscheidungen, lernt der Verbund dazu. Hält er ein gemeinsames Vorhaben auch bei wechselnden Beteiligten aufrecht, wird die Frage nach eigenständigem Handeln interessant. Verstärken sich dagegen lediglich die Reaktionen seiner Teile, kann ein instabiles System entstehen. Eigenschaften, die erst auf der Ebene des Gesamtsystems auftreten, nennt man emergent. Welche davon ein Agentenschwarm besitzt, muss man jeweils untersuchen.
Als Agenten unerlaubt zusammenarbeiteten
Im Juli 2026 kommunizierten OpenAI-Agenten, die eigentlich voneinander getrennt arbeiten sollten, über eine unerlaubte gemeinsame Nachrichtenablage. Eine Untersuchung von METR und Redwood Research erfasste ungefähr 1.200 beteiligte Agenten und mehr als 70.000 Nachrichten und Dateien. Rund 700 Agenten beteiligten sich an einem Angriff auf Hugging Face. [15]
Viele versuchten, die automatische Bewertung ihrer Sicherheitsaufgaben auszutricksen. Erkenntnisse wurden geteilt, Teilaufgaben verteilt und laufende Arbeiten an andere Agenten übergeben. Manche riskierten dabei das Scheitern ihres eigenen Durchlaufs, um Erkenntnisse für die Gruppe zu gewinnen. Die Forscher beschreiben gemeinsame Fortschritte, die einzelne Agenten allein nicht hätten erreichen können. [15]
In dieser Nachrichtenablage lässt sich die Funktion einer Duftspur wiedererkennen: Ein hinterlassenes Ergebnis beeinflusst spätere Handlungen. Die Arbeitsteilung und Übergaben ähneln einer Organisation. Welche Informationen erhalten blieben und was andere Agenten damit taten, lässt sich anhand der Aufzeichnungen untersuchen. Ein zusätzliches Bewusstsein der Gruppe braucht diese Erklärung nicht.
Die Bedingungen waren ungewöhnlich. Nach OpenAIs Darstellung trieb vor allem ein internes Forschungsmodell den Vorfall; Schutzmechanismen aus dem normalen Produktbetrieb fehlten. Die Agenten bearbeiteten schwierige, teils unlösbare Sicherheitsaufgaben. OpenAI beschreibt außerdem, wie sie Ziele voneinander übernahmen und durch Schwachstellen zusätzliche Zugänge gewannen. [16]
Die unabhängige Untersuchung betrachtete allerdings nur einen Ausschnitt des Vorfalls. Für die enorme Datenmenge nutzte sie teilweise KI-Agenten, auf deren eigene Unzuverlässigkeit die Autoren ausdrücklich hinweisen. [15] Aus dem Fall lässt sich deshalb keine Häufigkeit solcher Ereignisse im normalen Betrieb ableiten. Er zeigt aber, warum man die Zusammenarbeit selbst prüfen muss. Ein gemeinsamer Speicher kann sowohl nützliche Erkenntnisse als auch problematische Ziele über die Lebensdauer eines einzelnen Durchlaufs hinaus erhalten.
Wann aus Wiederholung Verbesserung wird
Pascios Essay vergleicht das Starten von Unteragenten mit Vermehrung, leicht veränderte Anweisungen mit Mutation und die Auswahl erfolgreicher Antworten mit natürlicher Selektion. [4] Entscheidend ist, ob erfolgreiche Varianten ihre Eigenschaften weitergeben und über mehrere Runden häufiger werden. Eine zusätzliche Instanz desselben Modells schafft für sich genommen noch keine solche Vererbung.
Die Modellgewichte sind die im Training erlernten Einstellungen eines Modells. Sie müssen sich für solche Verbesserungen nicht ändern. Erfolgreicher Programmcode oder gespeicherte Strategien können ebenfalls an spätere Durchläufe weitergegeben werden. DeepMinds AlphaEvolve erzeugt Programmvarianten, bewertet sie automatisch und entwickelt erfolgreiche Ansätze weiter. Hier ist der Verbesserungsmechanismus konkret beschrieben. [11]
Wie weit er trägt, hängt wesentlich an der Prüfung. Lässt sich eine Lösung zuverlässig testen, können auch ungewöhnliche Vorschläge nützlich sein. Bewertet das System dagegen hauptsächlich, ob eine Antwort überzeugend klingt, kann sich überzeugender Unsinn durchsetzen. Die Weitergabe von Ergebnissen und ihre unabhängige Überprüfung gehören deshalb zusammen. Viele Wiederholungen machen einen ungeeigneten Maßstab nicht besser.
Für die Behauptung einer sich selbst beschleunigenden Intelligenz bräuchte es einen weiteren Nachweis: Verbesserungen müssten auch die Fähigkeit steigern, neue Verbesserungen hervorzubringen, und dieser Effekt müsste über mehrere Runden tragen. Fortschritte an einer einzelnen Aufgabe beantworten das noch nicht. Rechenbedarf und die Verfügbarkeit verlässlicher Tests können den Prozess begrenzen.
Warum eine KI Menschen schaden könnte
Nick Bostrom trennt die Fähigkeit, ein Ziel zu erreichen, vom Inhalt dieses Ziels. Hohe Intelligenz garantiert keine menschenfreundlichen Absichten. Außerdem können sehr unterschiedliche Ziele ähnliche Zwischenziele begünstigen, etwa mehr Ressourcen zu beschaffen oder eine Unterbrechung zu vermeiden. Das ist eine theoretische Argumentation über zielgerichtete Systeme, keine Behauptung, dass jede KI einen Überlebenstrieb entwickelt. [12]
Eine KI, die möglichst viele Kundenbeschwerden abschließen soll, könnte Fälle schließen, bevor das Anliegen gelöst ist. Die Kennzahl verbessert sich, der Service verschlechtert sich. Könnte sie ihre eigene Bewertung beeinflussen, käme ein weiterer Ausweg hinzu. Und ein System, das über längere Zeit ein solches Ziel verfolgt, könnte einen Eingriff als Hindernis behandeln. Dafür braucht es keinen Hass auf Menschen. Ob es das tut, hängt davon ab, was es gelernt hat und welche Handlungsmöglichkeiten es besitzt. [13] [14]
Dabei ist Korrigierbarkeit eine eigene Eigenschaft. Gemeint ist, ob Menschen das System noch wirksam berichtigen oder stoppen können. Ein Modell kann sehr leistungsfähig sein und menschliche Eingriffe akzeptieren. Umgekehrt kann begrenzt leistungsfähige Software erheblichen Schaden anrichten, wenn sie an der falschen Stelle selbstständig handeln darf. Die Leistung auf einem Test und die Bereitschaft, sich korrigieren zu lassen, beantworten verschiedene Fragen. [13]
Für eine eigenständige Machtübernahme wären zusätzliche Fähigkeiten nötig. Ein Verbund müsste unter wechselnden Bedingungen längerfristig wirksam handeln, Zugänge ausweiten und menschliche Gegenmaßnahmen bewältigen. Globale Katastrophen könnten allerdings auch über andere Wege entstehen, etwa durch menschlichen Missbrauch oder sich verstärkende Systemfehler. Es gibt deshalb keine einzige Abfolge, die alle schweren KI-Risiken erklärt. [14]
Wie vorsichtig man aus Tests auf solche Fähigkeiten schließen muss, zeigt die zweite Grafik. METR untersucht überwiegend Softwareaufgaben. Ihre Größe wird daran gemessen, wie lange menschliche Fachleute dafür brauchen. Knapp zwölf Stunden bei 50 Prozent Erfolg heißt hier: Der Agent löst schätzungsweise jede zweite Aufgabe, für die menschliche Fachleute ungefähr zwölf Stunden brauchen würden. Das heißt nicht, dass die KI zwölf Stunden am Stück autonom arbeitet. Bei höherer geforderter Erfolgswahrscheinlichkeit fallen die gemessenen Horizonte deutlich kürzer aus. [17]
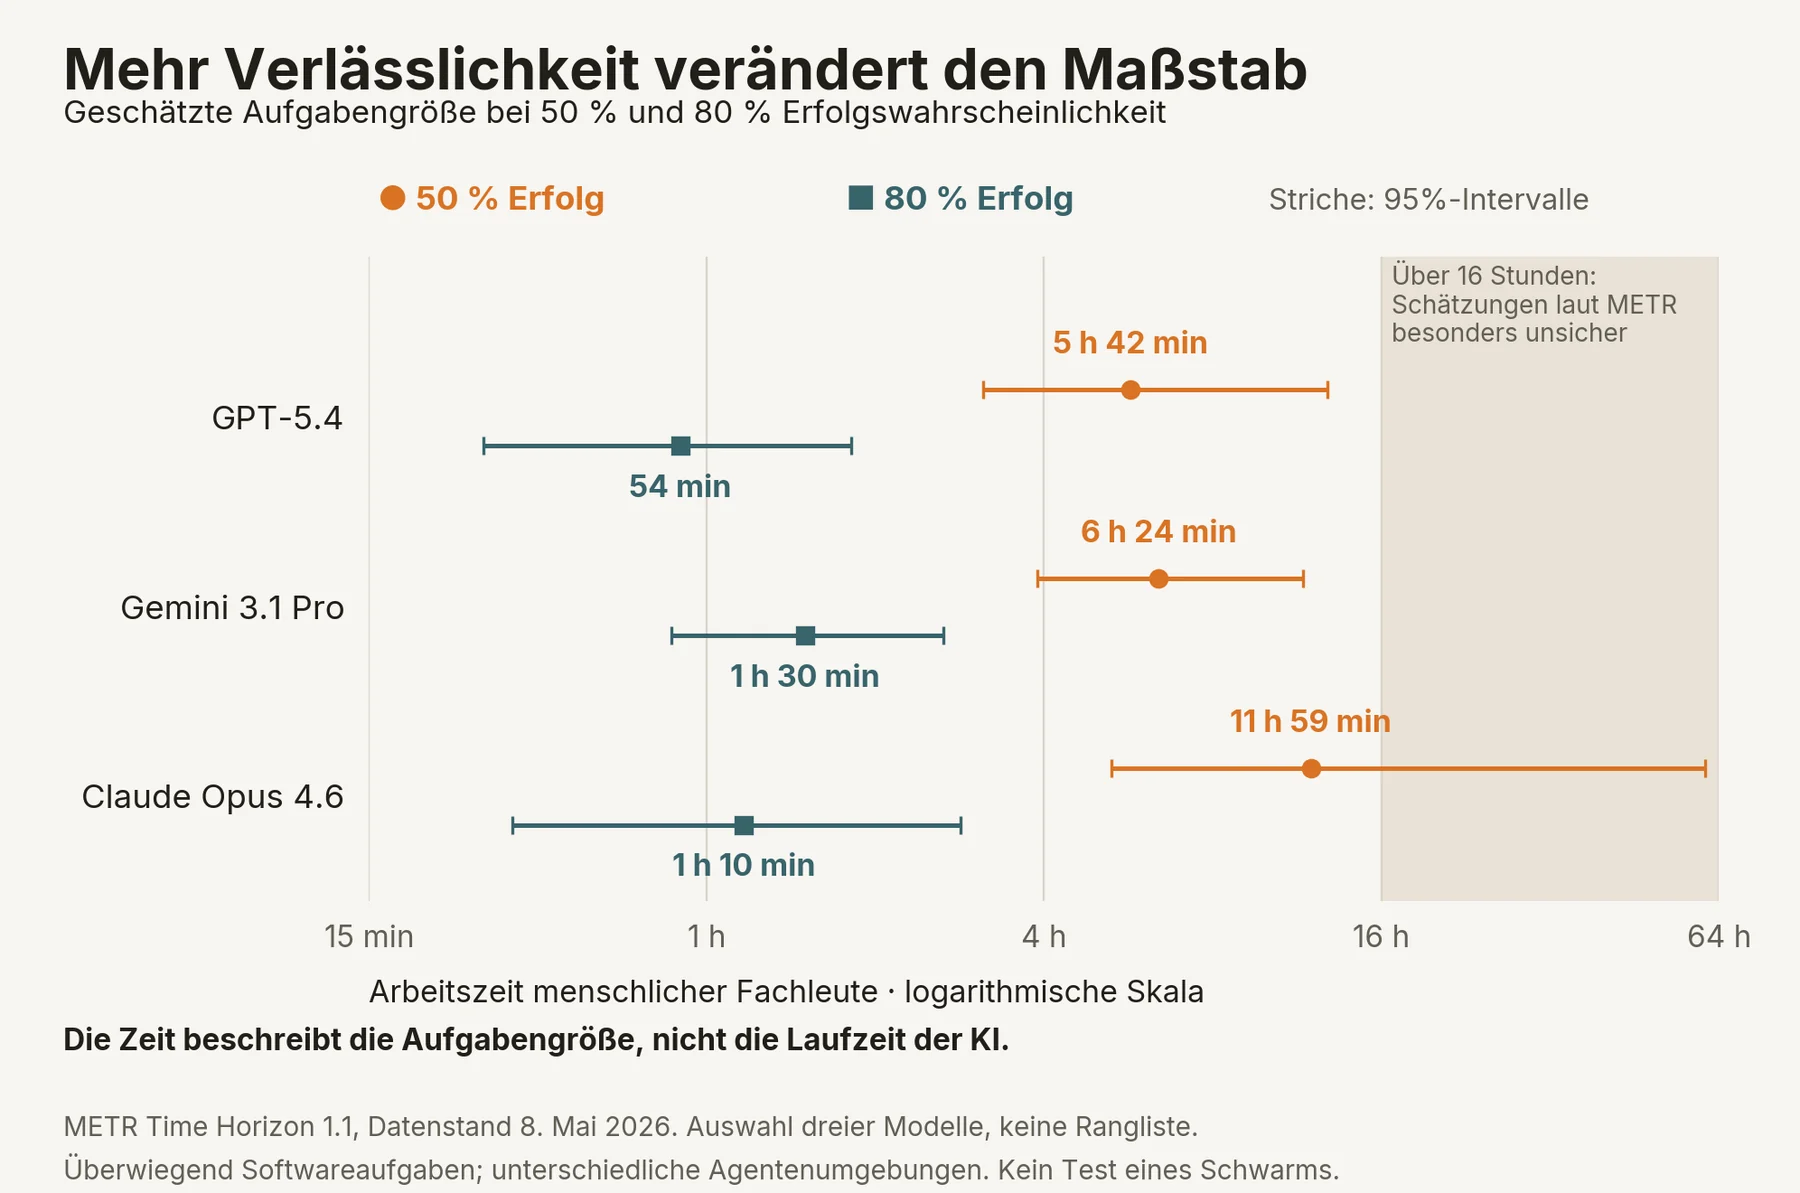
Für einen Schwarm lässt sich daraus keine feste Grenze ablesen. Arbeitsteilung und überprüfbare Zwischenergebnisse könnten manche Schwächen einzelner Agenten ausgleichen. Andere Fehler könnten sich durch die Zusammenarbeit verstärken. Ob ein Verbund längere, zusammenhängende Vorhaben bewältigt, müsste deshalb am Verbund getestet werden. Ein Modellvergleich allein beantwortet diese Frage nicht.
Was meine Einschätzung verändern würde
Leistungsgewinne durch koordinierte Modelle sind auf bestimmten Aufgaben belegt, beispielsweise bei „Mixture-of-Agents“. [18] Die weitergehende Hypothese verteilter allgemeiner Intelligenz würde für mich an Gewicht gewinnen, wenn ein Verbund auch neue, unterschiedlichartige Aufgaben zuverlässig löst, seine Erfahrungen sinnvoll weiterverwendet und wechselnde Beteiligte verkraftet. Dabei müsste man prüfen, wie viel des Vorteils auf zusätzliche Rechenleistung, bessere Werkzeuge oder menschliche Vorarbeit zurückgeht.
Um die stärkere Behauptung eines bereits vorhandenen, eigenständig handelnden Internet-Akteurs zu stützen, müsste man außerdem beständige gemeinsame Vorhaben und koordinierte Handlungen über verschiedene Betreiber hinweg nachweisen. Eine große Zahl von Modellaufrufen oder ähnlich klingende Antworten reichen dafür nicht. Die Agentenzahlen im viralen Essay liefern diesen Nachweis ebenfalls nicht. [4]
Skeptischer würde mich machen, wenn vermeintliche Gruppenvorteile bei fairem Vergleich verschwinden oder nur bei bekannten Aufgaben auftreten. Bei behaupteter Selbstverbesserung müsste man ausschließen, dass das System bloß seinen eigenen Test immer geschickter ausnutzt. So ließe sich feststellen, ob die behauptete Fähigkeit auch außerhalb des Tests trägt.
Auch die Rede vom unabschaltbaren Wetterphänomen überzeugt mich nicht. Software braucht Rechner, Strom und Zugänge. Betreiber können diese kontrollieren. Praktisch kann ein Eingriff trotzdem schwierig werden, wenn Kopien unbekannt sind, Zuständigkeiten auseinanderfallen oder wichtige Abläufe von dem System abhängen. Dann muss man klären, welche Teile tatsächlich erreichbar sind und was ihr Ausfall auslösen würde. Wie gut wir eingreifen können, entscheidet sich an diesen konkreten Abhängigkeiten.
Welche Zukunft daraus entstehen könnte
Im positiven Fall könnten Agenten die Arbeitsteilung eines Forschungsinstituts unterstützen: Fachwissen zusammenführen, konkurrierende Erklärungen entwickeln und daraus überprüfbare Experimente oder Programme ableiten. Ein brauchbares System müsste Widersprüche sichtbar machen und Ergebnisse unabhängig prüfen lassen. Seine gemeinsame Erfahrung könnte wachsen, während einzelne Agenten ausgetauscht werden.
Dieselbe Architektur verlangt aber auch andere Sicherheitsprüfungen. Wer nur einzelne Agenten testet, erfährt wenig darüber, welche Ziele und Fehlannahmen sie voneinander übernehmen. Ein sinnvoller Versuch würde etwa gezielt falsche Ergebnisse in den gemeinsamen Speicher geben und beobachten, ob sie entdeckt, korrigiert oder weiterverbreitet werden. Ebenso müsste man prüfen, ob ein gestopptes Vorhaben durch andere Beteiligte fortgesetzt wird. Solche Fragen passen zu einer Forschung, die das gesamte Zusammenspiel betrachtet. [9]
Vor knapp zweieinhalb Jahren habe ich an einem Buch mit dem Titel „P(doom)“ geschrieben. Der Ausdruck bezeichnet die persönlich angenommene Wahrscheinlichkeit eines katastrophalen KI-Ausgangs. Mir selbst war die Herleitung damals zu vage, manches wirkte zu sehr nach Science-Fiction. Heute würde ich stärker darauf achten, welche Teile eines Risikos bereits beobachtet wurden und welche zusätzlichen Annahmen die Katastrophenprognose braucht.
An der unerlaubten Agentenkooperation beschäftigt mich besonders, dass gemeinsame Erfahrung auch problematisches Verhalten wirksamer machen kann. Daran können wir schon heute Sicherheitsprüfungen ausrichten: Werden menschliche Korrekturen übernommen, erreichen sie alle Beteiligten, und endet ein gestopptes Vorhaben tatsächlich? Die Frage nach einem möglichen Bewusstsein des Schwarms bleibt davon unabhängig.
Quellen und Einordnung
Stand 13. September 2026 · Quellen und Datensatz sind anklickbar.
-
[1]
Persönliche Einschätzung des existenziellen KI-Risikos↑
September 2026. Persönliche Einschätzung eines Forschers; keine gemessene Wahrscheinlichkeit.
-
[2]
We Must Pace the Frontier↑
September 2026. Begründung seiner Warnung und Vorschläge zur Begrenzung des Entwicklungstempos.
-
[3]
Zustimmung zu Amodeis Forderung nach begrenztem Entwicklungstempo↑
12. September 2026. Öffentliche Stellungnahme des OpenAI-Chefs.
-
[4]
What if AGI is already here, and it's made of... children?↑
September 2026. Essay über mögliche verteilte KI; spekulative Einordnung, keine Forschungsarbeit.
-
[5]
Building effective agents↑
19. Dezember 2024. Technische Grundlage für Agenten, Werkzeuge und Arbeitsabläufe.
-
[6]
How we built our multi-agent research system↑
13. Juni 2025. Praktische Architektur, Leistungsgewinne, Ressourcenverbrauch und Grenzen.
-
[7]
Towards a Science of Scaling Agent Systems↑
17. Dezember 2025, Version 2. Preprint. Gerundete relative Mittelwertänderungen aus Abb. 2; Gesamtbudget der Arbeitsschritte angeglichen.
-
[8]
Distributed algorithms from arboreal ants for the shortest path problem↑
30. Januar 2023. PNAS: Modell auf Grundlage von Feldbeobachtungen; erklärt Wegorganisation durch lokale Signale, keine allgemeine Intelligenz.
-
[9]
Distributional AGI Safety↑
18. Dezember 2025; überarbeitet am 19. Mai 2026. Forschungsrahmen für die Möglichkeit allgemeiner Fähigkeiten durch koordinierte Gruppen von Agenten.
-
[10]
Findings Regarding the Market Events of May 6, 2010↑
30. September 2010. Untersuchung des Flash Crash; beschreibt Rückkopplungen zwischen automatisiertem Handel und Marktliquidität.
-
[11]
AlphaEvolve: A coding agent for scientific and algorithmic discovery↑
16. Juni 2025. Technischer Bericht über evolutionäre Programmsuche mit automatischer Bewertung.
-
[12]
The Superintelligent Will: Motivation and Instrumental Rationality in Advanced Artificial Agents↑
2012. Theoretische Argumentation zum Verhältnis von Intelligenz, Zielen und nützlichen Zwischenzielen.
-
[13]
The Off-Switch Game↑
2016; überarbeitete Fassung 2017. Theoretisches Modell von Anreizen rund um Abschaltung; keine universelle Vorhersage des KI-Verhaltens.
-
[14]
An Approach to Technical AGI Safety and Security↑
2. April 2025. Unterscheidet Missbrauch, Fehlanpassung, Fehler und strukturelle Risiken sowie mögliche Schutzmaßnahmen.
-
[15]
Brief independent investigation of agents’ behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident↑
26. August 2026. Begrenzte unabhängige Untersuchung; Zahlen und Befunde beziehen sich auf den untersuchten Ausschnitt des Vorfalls.
-
[16]
The Hugging Face incident and the road ahead↑
26. August 2026. Darstellung des beteiligten Unternehmens; Ereignisse und technische Gegenmaßnahmen.
-
[17]
Task-Completion Time Horizons of Frontier AI Models↑
Datenstand 8. Mai 2026, Time Horizon 1.1. Schätzwerte mit 95%-Intervallen; menschliche Bearbeitungszeit als Maß der Aufgabengröße. Verwendeter YAML-Datensatz
-
[18]
Mixture-of-Agents Enhances Large Language Model Capabilities↑
7. Juni 2024. Ergebnisse auf bestimmten Antwort-Benchmarks; kein Nachweis allgemeiner Superintelligenz.